On déploie une application web sur un serveur Linux, on lance un docker run et tout fonctionne en local. Deux mois plus tard, trois services tournent sur cinq machines, les conteneurs plantent la nuit et personne ne sait lequel relancer en premier. C’est exactement à ce moment que la question se pose : fallait-il apprendre Kubernetes plus tôt, ou Docker suffit-il encore ?
Construire une image Docker avant de parler d’orchestration
Avant de toucher à Kubernetes, on a besoin de savoir ce qu’on orchestre. Docker reste l’outil de référence pour le cycle de build : écrire un Dockerfile, construire une image, la tester localement, la pousser vers un registre. Même depuis que Kubernetes a retiré dockershim à partir de la version 1.24, les images construites avec Docker restent exécutables partout parce qu’elles respectent le format OCI.
A découvrir également : Qu'est-ce qu'un VLAN pour les nuls ?
Concrètement, si on ne maîtrise pas la construction d’une image propre (gestion des couches, multistage build, choix d’une base légère sur Linux), Kubernetes n’a rien à orchestrer. On se retrouve avec des pods qui redémarrent en boucle sans comprendre pourquoi le conteneur lui-même échoue.
Pour un développeur seul ou une petite équipe qui gère un ou deux services sur un serveur, Docker Compose couvre la majorité des besoins : définir des services, monter des volumes de données, exposer des ports. Passer à Kubernetes à ce stade revient à installer un système de gestion de flotte pour deux véhicules.
A découvrir également : Qu'est-ce qu'un cluster et un nœud dans Kubernetes ?
Kubernetes entre en jeu quand le nombre de conteneurs dépasse ce qu’on gère à la main
Le basculement vers Kubernetes se justifie par des contraintes précises, pas par une tendance. On en a besoin quand on doit coordonner des déploiements sur plusieurs machines, redémarrer automatiquement un service défaillant, ou répartir la charge entre des instances d’un même conteneur.
Signaux concrets pour passer à kubectl
- Plusieurs équipes déploient sur le même environnement et ont besoin d’isolation via des namespaces, sans se marcher dessus
- L’application web nécessite une mise à l’échelle automatique selon le trafic, avec des règles de planification que Docker Compose ne gère pas
- On utilise des outils natifs Kubernetes (Helm charts, opérateurs, CRDs) imposés par l’infrastructure de l’entreprise ou par un logiciel tiers
En dehors de ces cas, des alternatives plus légères existent. Des plateformes de conteneurs managées ou même un simple Docker Compose sur un serveur dédié couvrent le besoin sans la complexité d’un cluster Kubernetes autogéré.
Apprendre Docker puis Kubernetes : un ordre de progression logique sur le terrain
La question « Docker ou Kubernetes » est mal posée. Docker s’apprend en premier parce qu’il constitue la brique de base. On ne configure pas un déploiement Kubernetes sans comprendre comment fonctionne un conteneur, comment il accède au réseau, comment il persiste ses données.
Un parcours d’apprentissage réaliste ressemble à ceci :
- Maîtriser Docker en local : Dockerfile, docker build, docker compose up, inspection de logs et de volumes sur son ordinateur
- Déployer un premier service conteneurisé en production sur un serveur Linux avec Docker Compose, gérer les mises à jour d’image et les sauvegardes de données
- Passer à Kubernetes quand le contexte l’exige : installer un cluster local (minikube ou kind), manipuler kubectl, écrire des manifestes YAML pour des pods et des services
Cette progression n’est pas théorique. Elle reflète ce que font la plupart des équipes DevOps au quotidien. Apprendre Kubernetes sans base Docker revient à configurer un système d’exploitation sans savoir lancer un programme.
Le vrai obstacle à Kubernetes n’est pas technique
L’enquête CNCF 2024 place les changements culturels au sein des équipes parmi les premiers défis liés à l’adoption de Kubernetes, au même niveau que le manque de formation ou la complexité. Kubernetes impose un mode de travail par équipe plateforme, avec des pratiques CI/CD formalisées et des responsabilités opérationnelles clairement réparties.
Pour un développeur qui travaille seul ou dans une petite structure, cette dimension organisationnelle pèse plus lourd que la courbe d’apprentissage technique. Les retours varient sur ce point, mais beaucoup de petites équipes constatent qu’elles passent plus de temps à maintenir le cluster qu’à développer leur application.
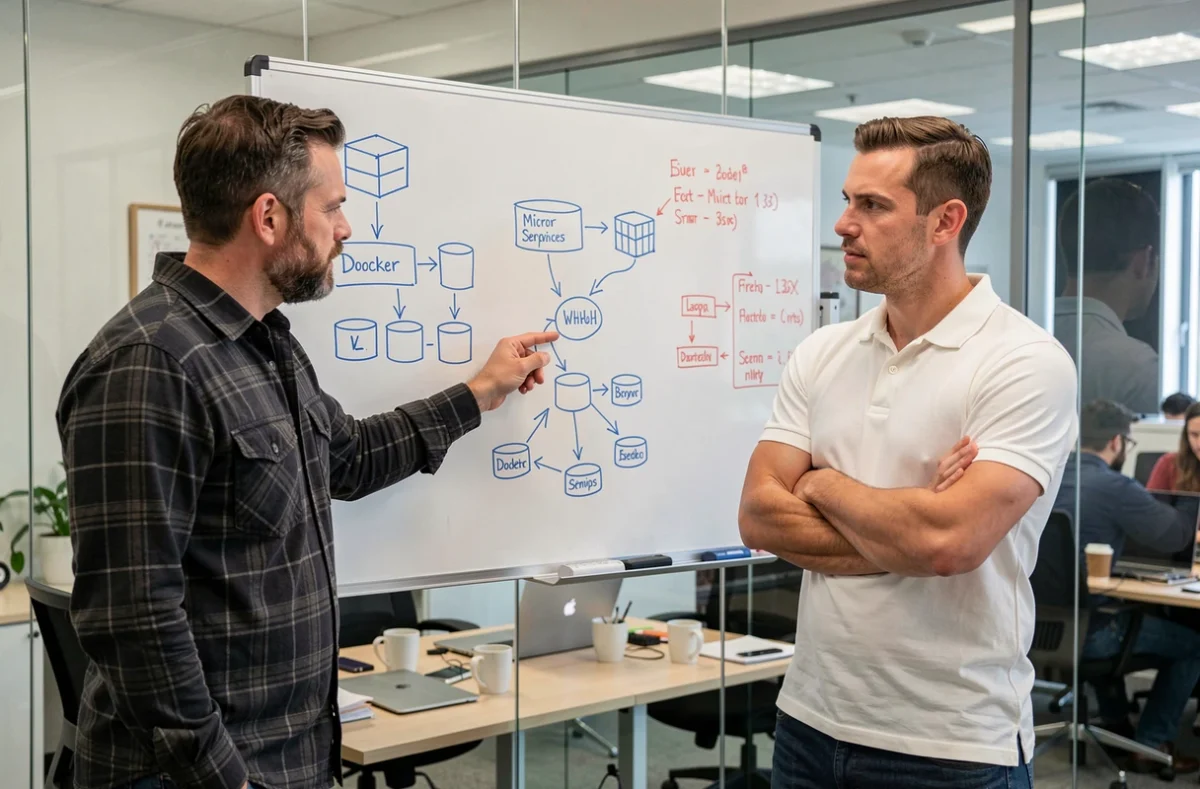
Docker Compose, Kubernetes managé ou Kubernetes autogéré : choisir selon la taille du projet
Le choix ne se limite pas à « Docker vs Kubernetes ». Il existe un continuum, et chaque palier correspond à une taille d’équipe et un volume de services.
Docker Compose convient quand on gère moins d’une dizaine de conteneurs sur un ou deux serveurs, sans besoin de mise à l’échelle automatique. L’environnement de développement local fonctionne de la même façon que la production, ce qui simplifie le débogage.
Un Kubernetes managé (type service cloud) retire la charge de maintenance du cluster. On écrit les manifestes, le fournisseur gère les mises à jour du système, la surveillance et la haute disponibilité. C’est le compromis le plus courant en entreprise.
Un Kubernetes autogéré sur ses propres machines n’a de sens que pour des organisations qui ont une équipe dédiée à l’infrastructure, des contraintes réglementaires sur l’hébergement des données, ou des besoins de planification spécifiques (GPU, bare metal).
Compétences DevOps recherchées : Docker et Kubernetes sur le même CV
Sur le marché du travail, les offres DevOps mentionnent presque systématiquement les deux. Savoir construire une image Docker et la déployer via un pipeline CI/CD constitue un socle attendu. Kubernetes différencie un profil junior d’un profil intermédiaire dès qu’on parle de production à l’échelle.
Apprendre Docker seul reste pertinent pour un développeur web qui veut fiabiliser ses environnements de développement et ses déploiements sur un serveur. Ajouter Kubernetes prend tout son intérêt quand on vise un poste orienté infrastructure, plateforme ou SRE, où la gestion de services distribués fait partie du quotidien.
La bonne approche consiste à commencer par Docker, à l’utiliser en production sur un vrai projet, puis à aborder Kubernetes quand la complexité du code et de l’infrastructure le justifie. Brûler les étapes ne fait que rallonger le temps passé à comprendre des erreurs qu’on aurait évitées avec une base solide en conteneurisation.