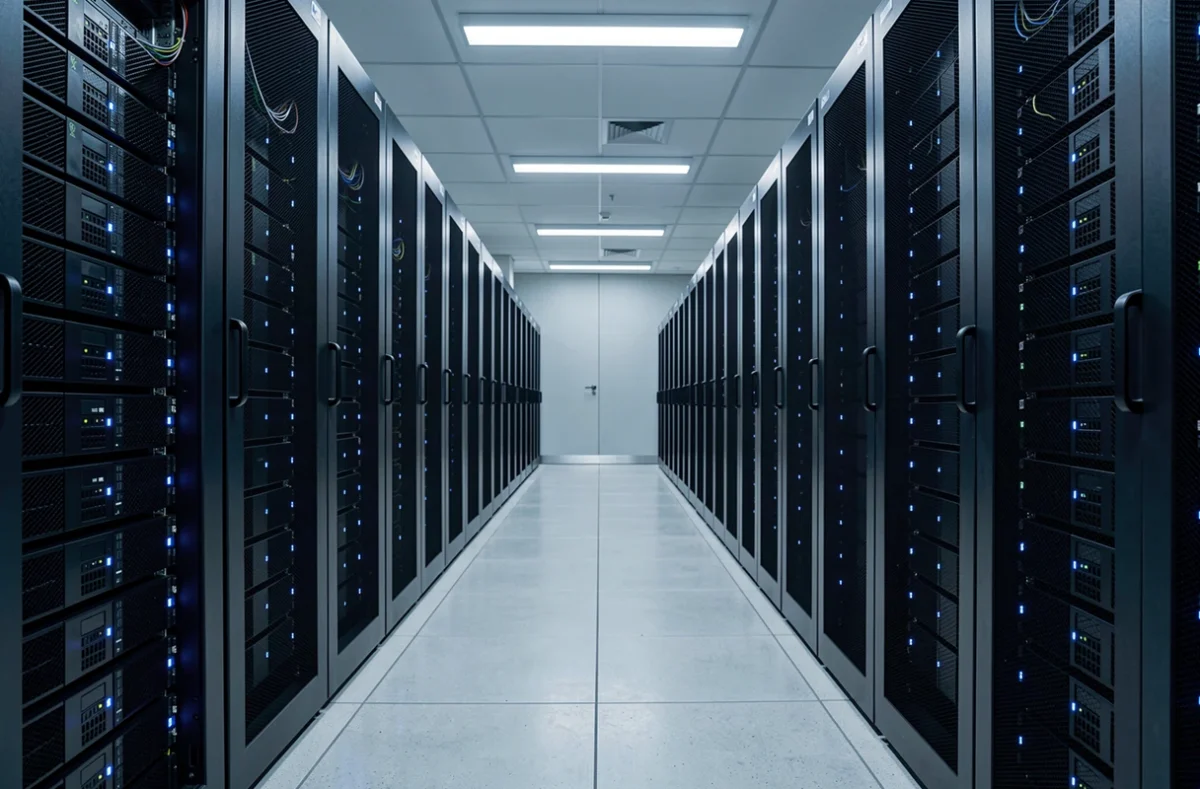
La définition de cluster en informatique tient en une phrase : un cluster, ou grappe, est un ensemble de machines reliées par un réseau qui fonctionnent comme un seul système. Il sert à garder un service en ligne malgré une panne, à additionner la puissance de calcul ou à mutualiser le stockage. Le mot a deux autres emplois, l’unité d’allocation d’un disque et le groupe de données produit par un algorithme, traités plus bas.
Cluster de serveurs : une grappe de machines vue comme un seul système
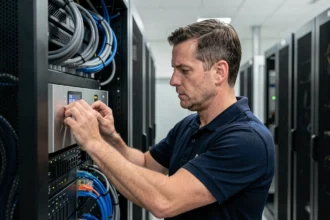
Dans son sens dominant, un cluster réunit plusieurs ordinateurs appelés nœuds. Chaque nœud dispose de son propre processeur et de sa propre mémoire, et un logiciel de gestion coordonne l’ensemble. Les applications s’exécutent comme sur une machine unique, sans que l’utilisateur voie la complexité sous-jacente.
A lire également : Qu'est-ce qu'un cluster et un nœud dans Kubernetes ?
Cette technique existe depuis les années 1960. Elle est aujourd’hui au cœur des sites à fort trafic, des bases de données et de l’hébergement cloud.
Cluster et nœud : qui fait quoi dans la grappe
Le nœud est une machine membre, le cluster est l’ensemble des nœuds. La différence compte dès qu’on lit une documentation : on redémarre un nœud, on administre un cluster. Pour un cas concret, le fonctionnement d’un cluster Kubernetes et de ses nœuds montre comment les rôles se répartissent entre plan de contrôle et nœuds de travail.
A découvrir également : Travail collaboratif en informatique : définition, outils et limites
Les nœuds se surveillent entre eux par des signaux réguliers appelés heartbeats. Ils maintiennent aussi un quorum, c’est-à-dire le nombre minimal de votes nécessaire au fonctionnement de la grappe. Ce mécanisme évite qu’une moitié isolée du cluster agisse de son côté et provoque des incohérences, situation que l’on nomme split-brain.
Haute disponibilité, calcul, stockage : les trois familles de clusters
Un cluster de haute disponibilité garde un service accessible malgré une défaillance. Quand un nœud tombe, les autres reprennent sa charge : c’est le basculement automatique, ou failover. En mode actif-actif, tous les nœuds travaillent en permanence. En mode actif-passif, certains attendent en réserve, ce qui gaspille du matériel mais reste plus simple à administrer. Des logiciels comme SQL Server ou les machines virtuelles Hyper-V s’appuient sur ce principe.
Un cluster de calcul haute performance répartit une tâche sur de nombreux nœuds qui la traitent en parallèle, par exemple pour la recherche médicamenteuse ou l’entraînement de modèles d’IA. Les ordinateurs quantiques relèvent d’une autre logique, avec leurs usages actuels de l’informatique quantique, mais le calcul en grappe reste la méthode courante pour les gros volumes.
Le stockage distribué répartit les données sur plusieurs machines, avec des volumes partagés auxquels plusieurs nœuds accèdent en même temps. La répartition de charge, qui distribue les requêtes entre les nœuds disponibles pour qu’aucun ne sature, se retrouve dans les trois familles.
Pourquoi relier plusieurs serveurs plutôt qu’en acheter un plus puissant
Une grappe continue de servir quand un nœud tombe, et sa capacité augmente en ajoutant des machines plutôt qu’en remplaçant la seule existante. Un site e-commerce l’utilise par exemple pour absorber les pics de trafic saisonniers sans investir dans un serveur géant. La maintenance se fait nœud par nœud, sans couper le service.
Ces avantages ont un prix. Une grappe demande une administration plus lourde et un réseau interne fiable. Le logiciel doit aussi être conçu pour tourner sur plusieurs machines, ce que ne font pas toutes les applications. Pour une petite structure, un seul serveur bien sauvegardé suffit souvent, comme le montrent les outils les plus utilisés en informatique, qui tournent presque tous sans grappe.
Cluster de disque : l’unité d’allocation d’un système de fichiers
Second sens du mot : le cluster est la plus petite portion d’espace qu’un système de fichiers attribue à un fichier. Il regroupe plusieurs secteurs du disque. Sur NTFS, le système de fichiers par défaut de Windows, sa taille est de 4 Ko par défaut.
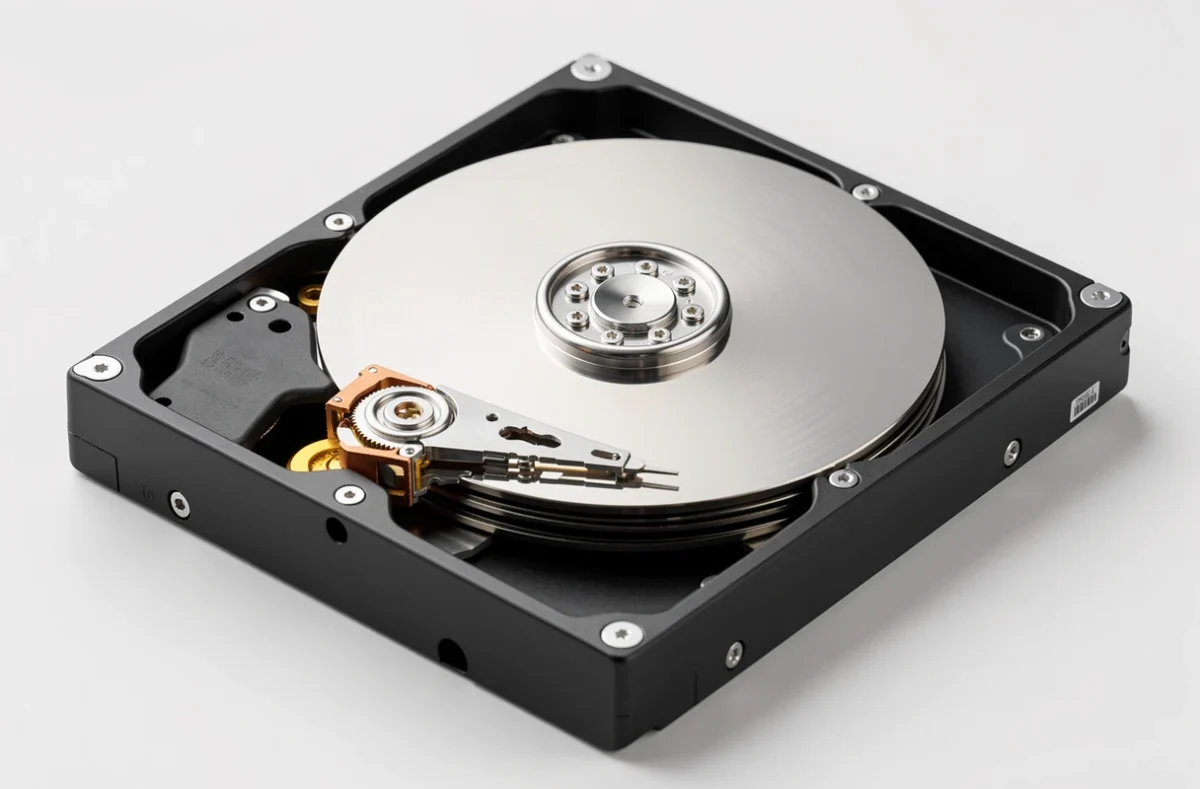
Conséquence concrète : un fichier de quelques octets occupe tout de même un cluster entier. C’est pour cette raison que la taille d’un fichier et sa taille sur disque diffèrent dans l’explorateur. Un cluster plus grand autorise des volumes plus vastes, jusqu’à 16 To pour 4 Ko, mais gaspille davantage d’espace avec les petits fichiers. Quand un secteur est défectueux, NTFS remappe le cluster concerné vers un cluster sain et marque l’ancien comme inutilisable.
Clustering de données : regrouper des éléments qui se ressemblent
Troisième emploi : en analyse de données, un cluster est un groupe d’éléments proches les uns des autres selon une mesure de distance. Un algorithme les forme sur des données non étiquetées, sans classes connues à l’avance. Les éléments d’un même groupe se ressemblent davantage entre eux qu’avec ceux des autres.
La méthode k-means en est un exemple : on fixe le nombre K de groupes, et l’algorithme calcule pour chacun un centre, le centroïde, autour duquel les éléments se rassemblent. On l’utilise pour segmenter une clientèle ou repérer des comportements atypiques.
Les trois sens partagent l’idée de rassembler des éléments en un ensemble cohérent : des machines, des secteurs de disque ou des données. Le contexte de la phrase indique lequel est visé, et seule la grappe de serveurs suppose un réseau et plusieurs ordinateurs.