Imaginez un tableur avec une feuille pour vos clients, une autre pour leurs commandes, et un lien entre les deux qui évite de recopier l’adresse à chaque ligne. C’est le principe d’une base de données relationnelle : des tables distinctes, reliées par des identifiants partagés. Créer cette structure demande moins de code qu’on ne le pense, mais quelques décisions prises au départ conditionnent la solidité de tout le projet.
Modéliser avant de coder : le schéma qui évite les reprises
La première erreur fréquente consiste à ouvrir un terminal SQL et à taper CREATE TABLE sans avoir dessiné le moindre schéma. Avant toute ligne de code, listez les objets concrets de votre projet : client, produit, commande, facture.
A lire aussi : Quels sont les inconvénients de la programmation ?
Chaque objet devient une table. Chaque propriété de cet objet devient une colonne (un attribut). Un client possède un nom, un courriel, une ville. Un produit possède une référence, un libellé, un prix.
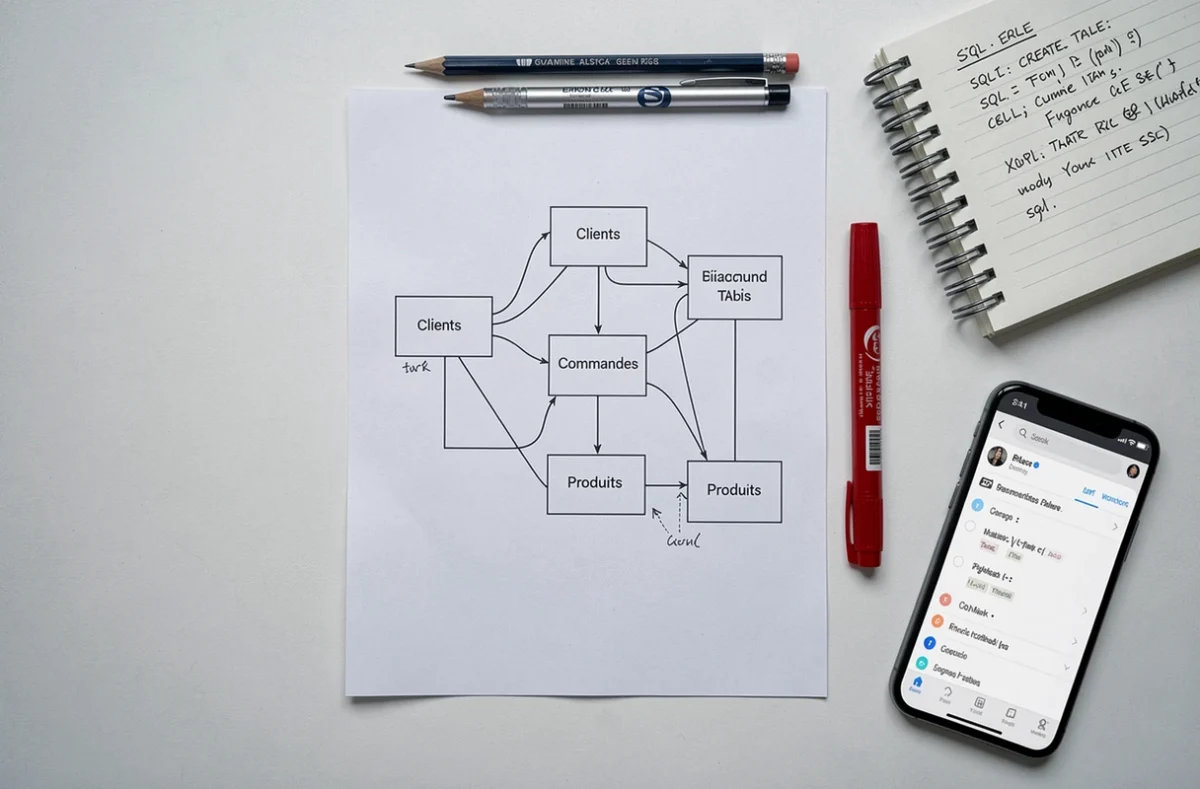
Prenez ensuite une feuille ou un outil de dessin et tracez les relations entre ces tables. Vous avez déjà remarqué qu’une commande concerne un client et un ou plusieurs produits ? Cette observation simple détermine la structure de vos clés.
A découvrir également : Qu'est-ce qu'un cluster et un nœud dans Kubernetes ?
Clé primaire et clé étrangère en pratique
Chaque table a besoin d’un identifiant unique par ligne : c’est la clé primaire. Un numéro auto-incrémenté suffit dans la plupart des cas.
Pour relier deux tables, on copie la clé primaire d’une table dans une colonne de l’autre. Cette colonne s’appelle la clé étrangère. Dans la table « commande », une colonne client_id pointe vers l’identifiant de la table « client ». Le moteur de base de données vérifie alors que chaque valeur de client_id correspond bien à un client existant.
Ce mécanisme garantit l’intégrité des données : impossible de créer une commande pour un client qui n’existe pas.
Choisir le type de relation entre vos tables
Toutes les relations ne se ressemblent pas. Identifier la bonne cardinalité évite de multiplier les colonnes inutiles ou de perdre des informations.
- Un-à-plusieurs (1:N) : un client peut passer plusieurs commandes, mais chaque commande appartient à un seul client. On place la clé étrangère du côté « plusieurs » (la table commande).
- Plusieurs-à-plusieurs (N:N) : une commande peut contenir plusieurs produits, et un produit peut figurer dans plusieurs commandes. On crée alors une table intermédiaire (souvent appelée « ligne_commande ») qui porte les clés étrangères des deux côtés.
- Un-à-un (1:1) : plus rare. Utile pour séparer des informations sensibles (mot de passe, données médicales) dans une table dédiée.
Si vous hésitez, posez-vous la question : « un élément de la table A peut-il être lié à combien d’éléments de la table B ? » La réponse dicte la structure.
Créer concrètement vos tables en SQL
Une fois le schéma posé sur papier, le passage au SQL est direct. Voici la logique pour une base simple avec deux tables.
La commande CREATE TABLE définit le nom de la table, ses colonnes, leurs types et les contraintes. Pour la table client : un identifiant entier en clé primaire, un nom en texte, un courriel en texte avec une contrainte NOT NULL pour interdire les valeurs vides.
Pour la table commande : un identifiant, une date, un montant, et une colonne client_id déclarée comme clé étrangère vers la table client.
Types de colonnes et contraintes utiles
Le choix du type de données (entier, texte, date, booléen) a un impact direct sur les performances et la cohérence. Stocker un code postal en texte plutôt qu’en entier évite de perdre les zéros initiaux. Stocker un prix en type décimal plutôt qu’en flottant évite les erreurs d’arrondi.
Chaque colonne mérite une contrainte explicite. NOT NULL empêche les valeurs manquantes. UNIQUE garantit qu’un courriel ne sera pas dupliqué. DEFAULT fixe une valeur par défaut quand aucune n’est fournie.
Ces contraintes constituent la première ligne de défense de vos données, bien avant le code applicatif.
Quel moteur SQL choisir pour démarrer
Le schéma et le SQL sont largement identiques d’un moteur à l’autre. Le choix se fait sur le contexte d’utilisation.
SQLite stocke toute la base dans un seul fichier. Aucun serveur à installer, aucune configuration réseau. C’est le choix le plus simple pour un projet personnel, un prototype ou une application mobile. Attention : en mode par défaut, les clés étrangères ne sont pas activées. Il faut exécuter PRAGMA foreign_keys = ON à chaque connexion pour bénéficier de la vérification d’intégrité.
MySQL reste très répandu dans l’hébergement web. La plupart des hébergeurs le proposent préinstallé. Sa documentation est abondante et la communauté large.
PostgreSQL offre un typage plus strict et des fonctionnalités avancées. La version 18, publiée en septembre 2025, a introduit notamment la fonction uuidv7() pour générer des identifiants universels triables chronologiquement, et les colonnes générées virtuelles. Pour un projet qui va grandir, PostgreSQL offre plus de marge de manœuvre.
Anticiper la portabilité et l’export des données
Concevoir un schéma propre ne sert pas uniquement la performance. Le règlement européen 2023/2854 impose des obligations de restitution et d’interopérabilité des données. Concrètement, cela signifie que votre structure doit permettre d’exporter les informations dans un format exploitable par un tiers.
Quelques pratiques simples facilitent cette portabilité :
- Nommer les tables et colonnes en anglais ou avec une convention stable (snake_case), sans caractères spéciaux.
- Documenter chaque table et chaque relation dans un fichier séparé, même un simple fichier texte.
- Éviter les types propriétaires d’un moteur si un type SQL standard couvre le même besoin.
- Prévoir dès le départ une commande d’export (pg_dump pour PostgreSQL, mysqldump pour MySQL, .dump pour SQLite).
Un schéma bien documenté et construit sur des types standards se migre d’un moteur à l’autre sans réécriture lourde. La portabilité se décide à la conception, pas après la mise en production.
La création d’une base de données relationnelle tient finalement en trois étapes : dessiner les tables et leurs liens, choisir un moteur adapté à votre contexte, puis écrire les CREATE TABLE avec des contraintes explicites. Le temps passé sur le schéma papier avant d’écrire la moindre ligne de SQL reste le meilleur investissement pour la suite du projet.